7B. GT-MD 流式渲染引擎
GT-MD 是高通自研的 Markdown 流式渲染引擎,位于 lib/gt_latex/gt_md_*,纯 C 实现、无操作系统依赖、以回调方式对接任意 GUI 系统与字库,专为嵌入式设备的 AI 流式输出场景设计。
与 gt_markdown 控件的关系: gt_markdown 控件(7.5 节)基于开源 md4c 组件做嵌入式优化,适合在 GT-HMI Designer2 工程中以零代码方式渲染静态 Markdown 文本;GT-MD 是引擎层 API,直接面向帧缓冲/画布绘制,支持逐块流式处理,适合在自有工程中接大模型流式输出,或对内存占用有严格要求的场景。两者可独立使用。
GT-MD 同时支持 Markdown 语法与内嵌 LaTeX 公式($...$、$$...$$)混合渲染,内嵌公式能力依赖 gt_latex 模块。
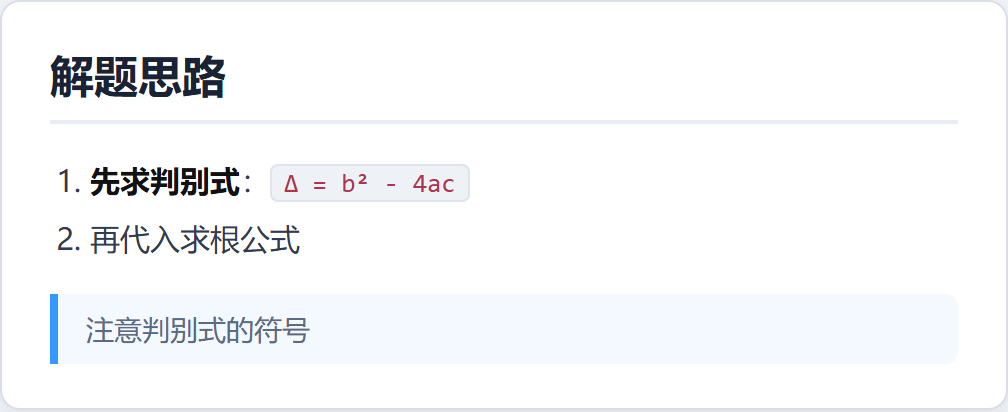 GT-MD 排版效果示意(标题层级、有序列表、粗体、行内代码、引用块,内容与本章示例 1 一致)
编译配置
在 gt_md_config.h 中配置。总开关 GT_MD_ENABLE(默认 1)。各语法特性可独立裁剪,用不到的特性置 0 后不占用 ROM:
| 宏 | 说明 | 默认值 |
|---|---|---|
GT_MD_CFG_ENABLE_HEADING | 标题 H1~H6 | 1 |
GT_MD_CFG_ENABLE_LIST | 有序/无序列表(嵌套深度见 GT_MD_CFG_MAX_NEST_DEPTH,默认 8) | 1 |
GT_MD_CFG_ENABLE_CODE_BLOCK | 围栏代码块 | 1 |
GT_MD_CFG_ENABLE_BLOCKQUOTE | 引用块 | 1 |
GT_MD_CFG_ENABLE_HR | 分隔线 --- | 1 |
GT_MD_CFG_ENABLE_BOLD | 粗体 **text** | 1 |
GT_MD_CFG_ENABLE_ITALIC | 斜体 *text* | 1 |
GT_MD_CFG_ENABLE_CODE_SPAN | 行内代码 `code` | 1 |
GT_MD_CFG_ENABLE_STRIKETHROUGH | 删除线 ~~text~~ | 1 |
GT_MD_CFG_ENABLE_LATEX | 内嵌 LaTeX 公式(需 gt_latex) | 1 |
常用约束宏:GT_MD_CFG_MAX_NEST_DEPTH(列表最大嵌套深度,默认 8)、GT_MD_CFG_MAX_LINE_LEN(单行最大字节数,默认 256)。
初始化:注册字库与绘制回调
GT-MD 的渲染层不直接访问字库数据,字体与绘制全部通过回调注入,因此可对接高通字库芯片,也可对接用户自有字库:
字库回调(布局阶段按 Unicode 码点查询字形尺寸):
// 字库回调:返回指定字符在指定级别字号下的宽高
static int my_font_get(uint32_t code,
                       const gt_latex_font_level_t *level_cfg,
                       gt_latex_glyph_metrics_t *metrics,
                       void *user_data)
{
    // 从字库查询 code 的字形宽度(高通字库芯片按字库 ID 直接索引)
    metrics->font_w = my_font_get_width(code, level_cfg->size);
    metrics->height = level_cfg->size;   // 字形高度等于字号
    metrics->axis   = level_cfg->size / 2;
    return 0;
}

// 注册字库回调
gt_latex_font_register(my_font_get, NULL);
gt_latex_font_level_t结构体包含:size(该级字号,像素高度)、font_type(字体类型,用户自定义含义,透传给回调)、font_flags(样式标志,Markdown 扩展字段)。
绘制回调(渲染阶段按码点自取位图绘制,引擎不介入字库数据):
// 注册绘制回调:字形、水平线(引用块/分隔线)、斜线段、圆弧
// 圆弧回调可为 NULL,此时括号等弧线退化为折线绘制
gt_latex_render_register(my_draw_glyph, my_draw_hline,
                         my_draw_line, NULL);
画布结构体 gt_latex_canvas_t:
| 字段 | 说明 |
|---|---|
x, y | 渲染起始坐标 |
fg_color | 前景色(字形、线条) |
bg_color | 背景色(可选) |
user_data | 透传给绘制回调的用户数据 |
ys, ye | 垂直裁剪区间(绝对坐标,0/0 = 不裁剪),滚动显示时用于只绘制可见区域 |
API 参考
一体化接口(推荐,静态文本):
| 函数 | 说明 | 返回值 |
|---|---|---|
gt_md_get_size(text, len, &w, &h, max_width) | 计算渲染尺寸(不绘制) | 0 成功,负数失败 |
gt_md_draw(text, len, &canvas, max_width) | 渲染 Markdown 文本到画布 | 0 成功,负数失败 |
流式接口(AI 流式输出,峰值内存仅为单块复杂度):
| 函数 | 说明 | 返回值 |
|---|---|---|
gt_md_get_size_stream(text, len, &w, &h, max_width) | 流式获取渲染尺寸,逐块处理 | 0 成功,负数失败 |
gt_md_draw_stream(text, len, &canvas, max_width) | 流式渲染,逐块处理 | 0 成功,负数失败 |
分步接口(需缓存布局、多次渲染时使用):
| 函数 | 说明 | 返回值 |
|---|---|---|
gt_md_parse_and_layout(text, len, max_width, &parser, &root, &layout) | 解析 + 布局一步完成 | 0 成功,负数失败 |
gt_md_render(&layout, &canvas) | 将布局结果渲染到画布(可多次调用) | 0 成功,负数失败 |
gt_md_free_all(&parser, root, &layout) | 释放 parse_and_layout 分配的所有资源 | — |
逐块迭代器(极低内存模式,块级流式):
| 函数 | 说明 | 返回值 |
|---|---|---|
gt_md_line_iter_init(&it, text, len, max_width) | 初始化逐块迭代器 | — |
gt_md_line_iter_next_size(&it, &w, &h) | 获取下一块渲染尺寸 | GT_MD_OK / GT_MD_EOF / 负数 |
gt_md_line_iter_next_draw(&it, &canvas) | 渲染下一块(y 偏移自动累加) | GT_MD_OK / GT_MD_EOF / 负数 |
全局配置:
| 函数 | 说明 |
|---|---|
gt_md_set_spacing(spacing) / gt_md_get_spacing(spacing) | 设置/获取全局间距配置(NULL 恢复默认) |
gt_md_set_latex_mode(mode) / gt_md_get_latex_mode() | 设置/获取内嵌 LaTeX 渲染模式(编译期固定时设置无效) |
返回值约定: GT_MD_OK(0) 成功;GT_MD_ERR_PARAM(-1) 参数错误;GT_MD_ERR_NOMEM(-2) 内存不足;GT_MD_ERR_SYNTAX(-3) Markdown 语法错误(通常降级处理);GT_MD_ERR_NO_CB(-6) 未注册必要回调;GT_MD_ERR_EOF(1) 输入结束(仅迭代器使用,非错误)。
示例 1:整段渲染(一体化接口)
// 初始化(系统启动时执行一次)
gt_latex_font_register(my_font_get, NULL);
gt_latex_render_register(my_draw_glyph, my_draw_hline,
                         my_draw_line, NULL);

// 渲染一段 Markdown
const char *text = "## 解题思路\n\n"
                   "1. **先求判别式**:Δ = b² - 4ac\n"
                   "2. 再代入求根公式\n\n"
                   "> 注意判别式的符号\n";

// 先取尺寸,再绘制
uint16_t w, h;
gt_md_get_size(text, strlen(text), &w, &h, 240);   // 限定最大宽度 240px

gt_latex_canvas_t canvas = {
    .x = 0, .y = 0,
    .fg_color = 0x000000,
    .bg_color = 0xFFFFFF,
    .user_data = NULL,
    .ys = 0, .ye = 0,
};
gt_md_draw(text, strlen(text), &canvas, 240);
示例 2:流式渲染(AI 输出逐段上屏)
大模型流式返回场景:每收到一段文本即调用一次流式接口,画布的 y 随已渲染高度累加,实现"边生成边显示":
int16_t cur_y = 0;

// AI 每返回一段文本调用一次
void on_ai_chunk(const char *chunk, uint16_t len)
{
    gt_latex_canvas_t canvas = {
        .x = 0, .y = cur_y,
        .fg_color = 0x000000,
        .user_data = NULL,
        .ys = 0, .ye = 0,
    };
    // 流式绘制:逐块处理,峰值内存仅为单块复杂度
    gt_md_draw_stream(chunk, len, &canvas, 240);

    // 累加本段高度
    uint16_t w, h;
    gt_md_get_size_stream(chunk, len, &w, &h, 240);
    cur_y += h;
}
内存特性
- 流式接口与逐块迭代器:峰值内存仅为单个 Markdown 块(一个段落/一个列表项等)的解析与布局开销,与全文长度无关,适合 KB 级内存的 MCU。
- 一体化与分步接口:需持有全文解析结果,适用于静态文本或需要多次渲染同一内容的场景(分步接口布局一次、渲染多次)。